AI内容评分:含义与使用方法
AI内容评分是一种概率估算,而非最终判定。当检测工具返回“72% AI”时,它表示所分析文本中大约72%的部分呈现出与大型语言模型相关的统计模式。这个数字可能有用,也可能具有误导性,甚至两者兼有,具体取决于你如何解读它。本指南将解释评分实际衡量的内容、检测工具为何会产生分歧,以及如何围绕结果制定合理的政策。
AI内容评分实际衡量的内容
AI内容评分:含义与使用方法 - AI内容评分实际衡量的内容.
AI内容评分:含义与使用方法 - AI内容评分实际衡量的内容。
检测工具不会将你的文本与已知AI输出的数据库进行比对。相反,它们会分析以下属性:
- 可预测性——在给定前文语境的情况下,每个下一个词出现的可能性有多大
- 句子变化——句子长度和结构是否自然波动
- 重复性——反复出现的措辞、过渡语或节奏模式
- 困惑度和突发性——区分机器典型文本与人类典型文本的统计信号
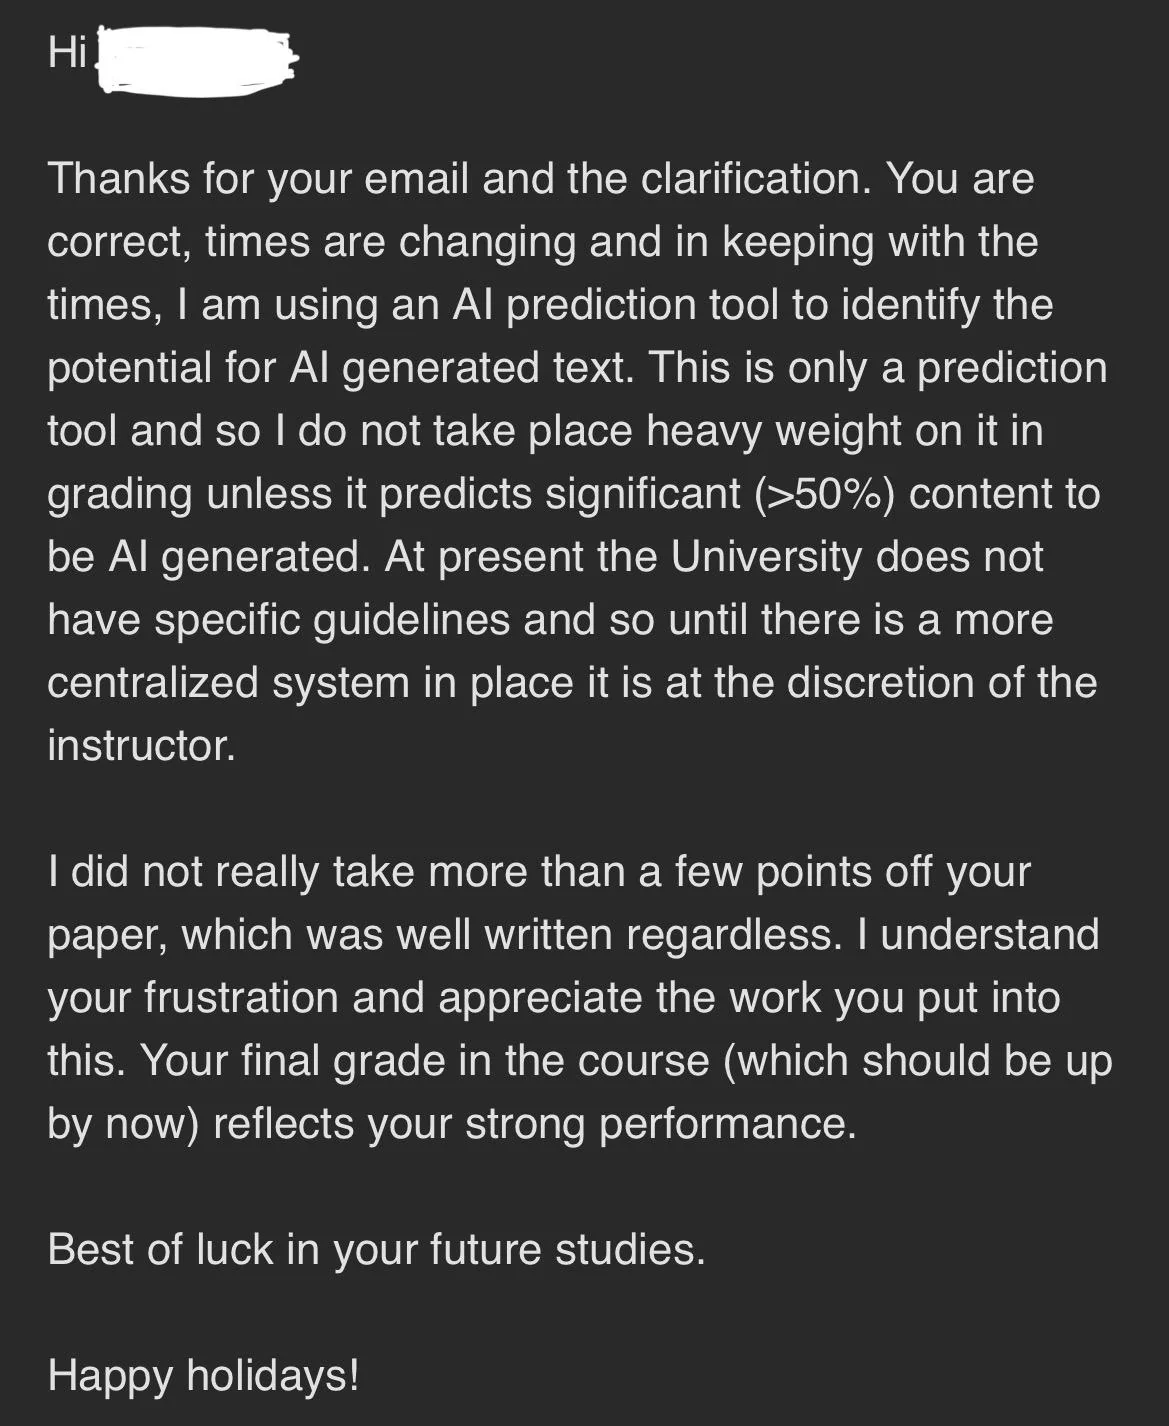
50%的评分并不意味着有一半的单词是由聊天机器人撰写的。它意味着模型发现了足够多的机器典型模式,从而给出了这一概率。大多数现代检测工具在段落或句子层面工作,然后进行汇总,这就是为什么你经常看到的是高亮标记的片段,而不是一个统一的数字。
为什么同一段文本会得到不同的评分
AI内容评分:含义与使用方法 - 为什么同一段文本会得到不同的评分.
AI内容评分:含义与使用方法 - 为什么同一段文本会得到不同的评分。
将相同的文本放入三个检测工具中,你可能会得到三个不同的百分比。这是正常现象,也是你在根据任何评分采取行动之前最需要了解的一点。
不同的训练数据,不同的阈值
每个检测工具都在自己的数据集上训练,并针对自身在误报和漏报之间的平衡进行调优。一个以避免标记人类写作为优化目标的工具,会低估AI文本。一个以捕捉AI文本为优化目标的工具,则会过度标记经过润色的人类写作。
长度和语言很重要
短样本不可靠。大多数工具建议至少80–100个单词,而且准确率通常会随着段落变长而提高。多语言支持也差异很大;对翻译文本的评分通常不如对母语文本的评分可信。
编辑模糊了界限
由人类起草、然后用AI工具润色的文本处于灰色地带。有些检测工具将其归类为“轻度AI辅助”,有些归类为“混合”,还有些归类为完全由AI生成。这些类别标签在整个行业中并未标准化。
如何解读评分区间
AI内容评分:含义与使用方法 - 如何解读评分区间.
AI内容评分:含义与使用方法 - 如何解读评分区间。
与其把这个数字当作通过/不通过,不如将其映射到一个区间。一种实用的解读方式如下:
| 评分范围 | 可能的解读 | 典型行动 |
|---|---|---|
| 0–20% | 人类撰写或标准写作辅助 | 无需行动 |
| 20–60% | 混合或AI辅助起草 | 审查背景和政策 |
| 60–100% | 以AI生成模式为主 | 在发布或评分前进行调查 |
这些区间是惯例,而非标准。40%的评分在一种编辑政策下可能完全可以接受,在另一种政策下则可能是严重问题。阈值应来自你的政策,而不是工具。
检测工具与抄袭检查工具
AI内容评分:含义与使用方法 - 检测工具与抄袭检查工具.
AI内容评分:含义与使用方法 - 检测工具与抄袭检查工具。
这些工具回答的是不同的问题,混淆它们会导致糟糕的决策。
- AI检测工具问的是:这段文本看起来像机器生成的吗?
- 抄袭检查工具问的是:这段文本与现有来源匹配吗?
文本可以完全原创,但在AI检测工具上得分很高。文本可以大量抄袭,但在AI检测工具上得分为0%。如果你同时关心原创性和作者身份,就需要两种检查。要更全面地了解搜索和AI系统如何评估来源质量,请参阅AI可见性:如何被AI搜索引擎引用。
AI内容评分无法告诉你的事情
检测评分是一种信号,而非证据。它无法告诉你:
- 文本是谁写的
- 作者是否仅将AI用于头脑风暴
- 内容是否准确、有用或经过充分研究
- 它是否会获得排名、转化或让读者满意
这就是为什么主要供应商都会发布注意事项。QuillBot明确表示,评分是信号而非判定,并警告不要仅凭检测评分做出学术或就业决定。Pangram同样将检测描述为从完全人类到完全AI生成的区间,并附有置信水平。Scribbr指出,没有检测工具能做到完全准确,检测工具始终在与不断演变的语言模型赛跑。
构建实用的AI内容工作流程
如果你大规模发布内容,你需要的是一个流程,而不是单一检查。
1. 先定义你的政策
决定AI可以扮演什么角色:构思、列大纲、起草、编辑,还是以上都不允许。你的政策决定你的阈值。没有政策,每个评分都会变成争论。
2. 在合适的粒度上检查
扫描完整文档,而不是片段。查看高亮片段,了解机器典型模式集中在哪里。在一篇整体听起来像人类撰写的文章中,只有一个段落被标记,通常意味着轻度编辑,而不是整体生成。
3. 对高风险内容增加人工审核
对于学术工作、新闻业或受监管行业,将评分与对话或编辑审核结合起来。请作者解释他们的流程。评分开启对话,而不是结束对话。
4. 将检测与质量分开
低AI评分不会让内容变好,高评分也不会让内容变差。应根据内容本身评估其有用性、准确性和原创性。如果你使用WordPress,WordPress上的Yoast SEO介绍了如何在作者身份信号之外处理schema、元数据和工作流程检查。
5. 跟踪评分随时间的变化,而不是孤立看待
团队中评分突然跃升,通常指向工作流程变化,而不是个人不当行为。趋势数据比任何单一结果都更具可操作性。
AI检测在内容运营中的位置
检测是质量控制步骤,而不是内容策略。持续发布的团队往往将其视为众多检查点之一:关键词规划、起草、编辑审核、发布和衡量。
一些平台将这些步骤整合到一个工作空间中。例如,AgentBooks围绕将公司网站转变为可重复的内容引擎而构建——抓取网站以建立事实来源、规划主题、通过审批工作流程生成文章,并发布到托管网站。在这种流水线中,AI内容评分最有用的地方是作为审批前的审核关卡,而不是替代编辑判断。如果你正在比较处理此工作流程部分环节的工具,ContentBot.ai评测和QuickCreator评测都探讨了生成在哪里结束、审核从哪里开始。
AI内容评分的常见错误
- 把数字当作成绩。 它是概率,不是分数。
- 纯粹为了降低评分而修改。 为满足检测工具而重写,可能会削弱清晰度和声音,却不会改善内容。
- 忽视误报。 非英语母语写作者和高度正式的写作者比普通人更容易被标记。
- 假设一个工具就是权威。 当风险很高时,应交叉验证。
- 跳过披露。 如果使用了AI,说明这一点通常比试图操纵评分更简单、更安全。
相关阅读
- ContentBot.ai定价:套餐、字数限制、真实成本 - 解释ContentBot.ai定价:预付费费率、Starter、Premium和Premium+套餐、字数配额、导入上限,以及每个可用单词的真实成本。
- CRM QuickCreator:AI内容如何连接到你的CRM - 了解QuickCreator的Conversion Agent如何将文章转化为可进入CRM的潜在客户,它擅长什么、在哪里停止,以及AgentBooks如何融入工作流程。
来源与延伸阅读
- 免费AI检测工具 - Scribbr AI Detector:使用我们先进的AI Checker识别来自ChatGPT、Copilot和Gemini的AI生成内容。免费试用!
- AI检测工具:适用于ChatGPT、Claude和GPT-6的免费AI检查器 - Quillbot的免费AI Detector可检查来自ChatGPT、GPT-6、Claude等的文本。获取AI评分、句子级高亮和精细的AI检测洞察。
- 你的AI检测评分意味着什么? - AI检测评分不像传统的评分标准那样“通过”和“不通过”一目了然。“完全由AI生成”和“AI编辑”之间的细微差别正在演变,Pangram的检测系统也是如此。
常见问题
什么是好的AI内容评分?
没有普遍适用的好评分。在大多数政策下,0–20%被视为人类撰写或轻度辅助,20–60%为混合,60%以上则需要审查。应由你的政策定义阈值,而不是工具。
AI内容评分会出错吗?
会。检测工具使用统计模型,因此它们基于概率而非确定性运行。对于非母语写作者和正式文体,误报很常见;当AI文本经过大量编辑或人性化处理后,也会出现漏报。
AI检测工具会检查抄袭吗?
不会。AI检测工具寻找机器典型模式;抄袭检查工具则将文本与现有来源进行比对。一份文档可以是原创的,但在AI检测工具上得分很高。
要获得准确评分需要多少单词?
大多数工具建议至少80–100个单词,样本越长准确率越高。非常短的段落会产生不可靠的结果。
我应该仅仅为了降低AI评分而重写内容吗?
通常不应该。如果内容准确、有用且符合你的政策,仅凭评分就重写的理由很弱。应为了清晰度和实质内容而修改。
高AI内容评分会损害SEO吗?
搜索引擎关注的是有用性、原创性和质量,而不是检测百分比。高评分本身不是排名惩罚,但内容单薄、无用无论怎样产生都是真正的风险。
结论
AI内容评分是一种诊断信号,而不是评判。它告诉你机器典型模式在文本中集中在哪里,并且其准确性会因工具、样本长度和语言而异。将其作为更广泛审核流程中的一项输入:定义你的政策,在文档层面检查,审查被标记的片段,并让人类判断参与其中。把百分比当作需要调查的问题,而不是需要接受的答案。